Pourquoi ce sujet compte maintenant
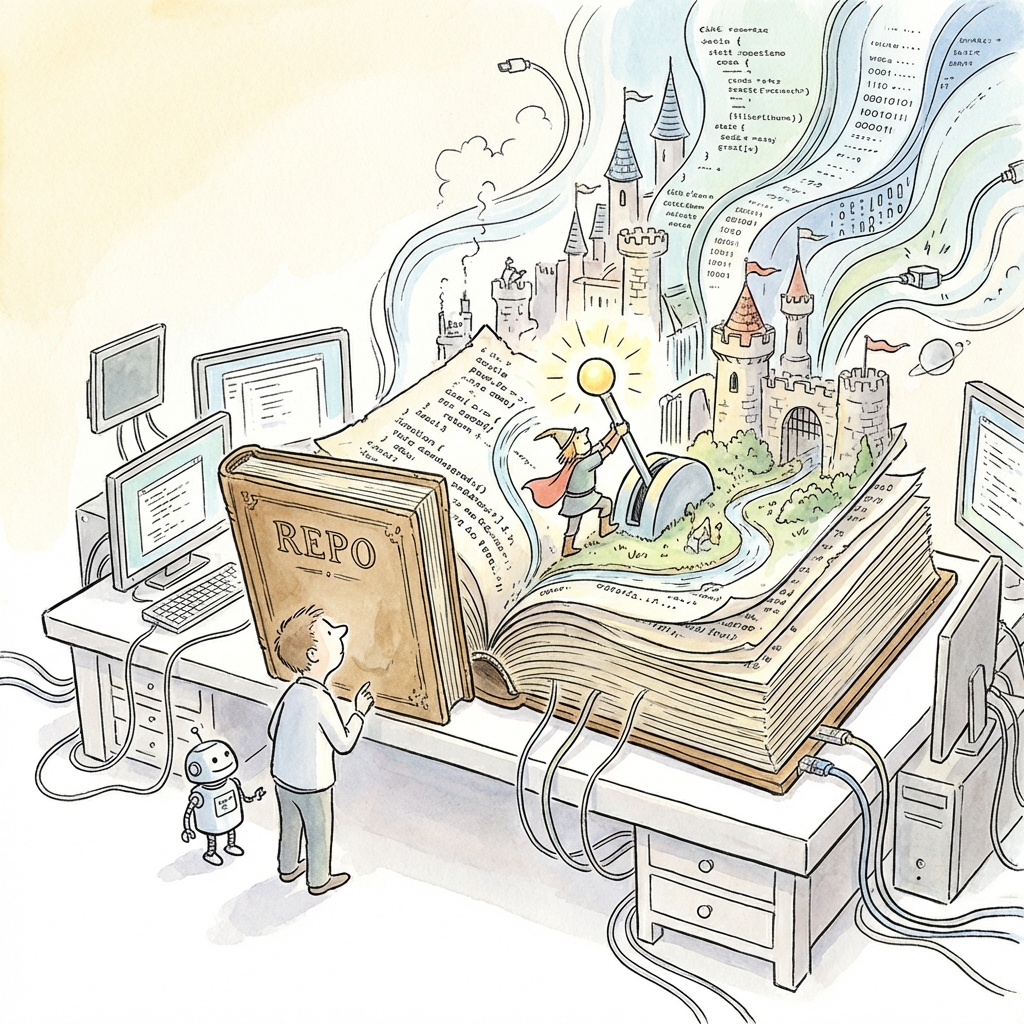
On parle souvent de modèles, de contexte, de prompting. Mais dans les gros dépôts, le vrai problème est plus basique: l’agent ne “voit” pas le projet comme nous.
Le papier Closing the Loop: Universal Repository Representation with RPG-Encoder (arXiv:2602.02084, publié le 2 février 2026) attaque exactement ce point. L’idée centrale: tant qu’on garde des vues fragmentées (API docs d’un côté, graphe de dépendances de l’autre, snippets isolés), on a un agent qui génère du code sans comprendre l’intention globale.
Ce qu’il faut comprendre en premier
Ce que j’aime dans ce papier, c’est qu’il ne vend pas une magie de plus. Il reformule le problème correctement.
- La génération de code “déplie” une intention vers une implémentation.
- La compréhension de repo “replie” l’implémentation vers une intention.
- Si ces deux boucles n’utilisent pas la même représentation, on perd de l’information à chaque passage.
RPG-Encoder propose donc une représentation commune du repo, avec signaux sémantiques + structure de dépendances, et une mise à jour incrémentale pour ne pas exploser les coûts quand le dépôt grossit.
Analyse detaillee
Concrètement, pourquoi ça peut changer notre manière de bosser avec des agents?
-
Localisation plus fiable Sur des tickets réels, la moitié du temps part dans “où agir” avant même d’écrire une ligne. Le papier revendique 93,7% Acc@5 sur SWE-bench Verified et un gain >10% sur SWE-bench Live Lite face au meilleur baseline. Même sans prendre ces chiffres comme vérité absolue, la direction est claire: meilleure cartographie = moins de edits hors cible.
-
Coût de maintenance réduit Le point souvent oublié: une représentation riche du repo coûte cher à maintenir. Les auteurs annoncent une baisse d’overhead de 95,7% grâce à l’évolution incrémentale de la topologie. Pour nous, cela signifie potentiellement des agents plus “always-on” sans facture qui part en orbite.
-
Pont entre compréhension et génération Le papier parle de “closing the loop”: on n’a plus un outil pour lire et un autre pour écrire, mais un même socle. Dans la pratique, c’est exactement ce qu’il manque dans beaucoup de workflows agentiques actuels: un état interne cohérent entre analyse et exécution.
-
Impact direct sur les revues humaines Si l’agent comprend mieux l’architecture, on récupère moins de PR “plausibles mais mal placées”. La review redevient une validation de choix, pas une chasse aux contresens de structure.
Erreurs frequentes et limites
Il faut rester prudent.
D’abord, on est sur un papier de recherche, pas sur un produit prêt à brancher dans tous les IDE demain matin. Ensuite, les benchmarks restent des benchmarks: les gains sur SWE-bench ne garantissent pas automatiquement des gains identiques sur vos monorepos, avec votre stack et vos conventions.
Autre point: une représentation plus riche peut améliorer la précision, mais elle ajoute aussi une couche système à opérer. Donc oui, moins d’erreurs de localisation possibles, mais plus de complexité d’infra à maîtriser.
Enfin, il faut éviter le raccourci “nouvelle représentation = fin des hallucinations”. Cela réduit des classes d’erreurs, pas la totalité des erreurs. Le niveau de gain exact sur des stacks hétérogènes reste encore à vérifier en conditions d’équipe hors benchmark.
Ce que ça change pour les devs
Pour aller plus loin sans repartir de zero, regardez aussi notre playbook de cadrage des agents et notre guide QA en CI pour limiter les faux positifs.
Mon verdict: c’est un des papiers les plus utiles du moment pour les équipes qui veulent industrialiser des agents de code sur des repos non triviaux.
- Testez d’abord RPG sur une zone de code stable pour mesurer un delta de précision réel.
- Conservez un protocole de review humain strict pendant la phase de montée en charge.
- Comparez les résultats sur 2 à 4 semaines avant de généraliser à tout le repository.
La leçon pratique est simple: avant de chercher le “meilleur modèle”, posez la question “quelle représentation partagée du codebase alimente nos agents?”. Si la réponse est “aucune”, vous avez probablement trouvé votre prochain goulot d’étranglement.
Verdict et prochaine etape
Dans un prochain article, on peut traduire cette idée en checklist d’implémentation côté équipe: quelles métadonnées indexer, quel rythme de refresh, quels signaux garder pour un agent de code en production.
Si vous voulez cette checklist en version opérationnelle, abonnez-vous à la newsletter: on enverra un template directement réutilisable en équipe.
Sources: